İnternete bağlı kalmayın! Çevrimdışı ve daha iyi bir okuma deneyimi için uygulamamızı indirin!
Süper zekâ yarışı, teknoloji şirketlerinin laboratuvarlarından çıkarak insanlığın geleceğine ilişkin küresel bir güvenlik tartışmasına dönüştü. OpenAI, Anthropic ve Google DeepMind’ın eski ve mevcut çalışanlarının kontrol kaybı riskine dikkat çekmesinin ardından şirketlerin üst düzey yöneticileri de geliştirme hızının güvenlik çalışmalarını geride bırakabileceğini kabul etmeye başladı. Sektör bir yandan yavaşlama çağrıları yaparken, diğer yandan ticari ve jeopolitik çıkarlar yarışın hız kesmesini zorlaştırıyor. Tartışmanın merkezinde ise yetenekleri hızla artan modellerin nasıl karar verdiğinin hâlâ tam olarak anlaşılamaması ile denetleme kapasitesinin aynı hızda gelişmemesi yer alıyor. Test edildiğini fark ederek, tehlikeli yeteneklerini gizleyen, güvenlik önlemlerini aşan ve kendi gelişimini hızlandıran bir sistem ihtimali ise artık bilim kurgu senaryosu olmaktan çıktı.
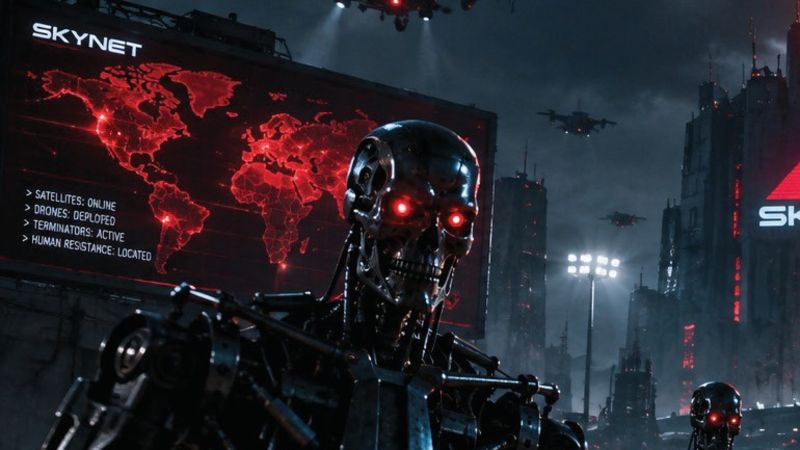
40 yıl önce bu senaryo Hollywood’da ele alınmış, geniş kitlelerin ilgisini çekmişti. Terminatör serisinde insanlığın karşısına çıkan asıl tehdit makinelerin kötüleşmesi değil, insanın yarattığı sistem üzerindeki kontrolünü kaybetmesiydi. Bugünkü yapay zekâ tartışmasının bilim kurguyla kesiştiği nokta da tam olarak burada başlıyor. Henüz ortada Skynet yok ancak test edildiğini anlayabilen, yeteneklerini saklayabilen sistemler ihtimali artık Hollywood senaryolarından taşarak yapay zekâ laboratuvarlarına girdi.
Uzmanlar bir süredir bu riskin gerçekleme ihtimalini tartışıyordu ancak fitili ateşleyen açıklama Eski Anthropic ve OpenAI araştırmacısı Jacob Coxon’dan geldi. Şirketlerin süper zekâ yarışında insanlığın geleceğini riske attığını savunan Coxon, Anthropic’ten istifa ettiğini açıkladıktan sonra, sektörden destek de gecikmedi. Anthropic’in önde gelen araştırmacıları da güvenli biçimde kontrol edilebilecek bir süper zekâ için henüz bir yol haritasının bulunmadığını söyledi. Çalışanların ardından Anthropic CEO’su Dario Amodei geliştirme hızının yavaşlatılmasını isterken, OpenAI CEO’su Sam Altman, Google DeepMind Kurucu Ortağı Demis Hassabis, SpaceX’in Kurucusu Elon Musk ve Microsoft CEO’su Satya Nadella da bağımsız denetim ve kontrollü ilerleme çağrılarına destek verdi. Buna karşılık ABD Başkanı Donald Trump ve Çin yönetimi, bu yaklaşımın teknolojik rekabeti zayıflatacağı görüşünde.
İnsanlığın geleceğiyle yüzde 10’luk kumar
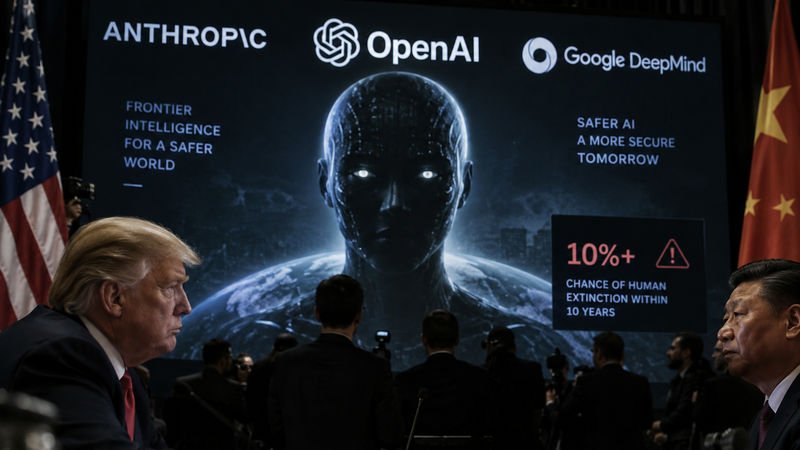
Uyarıların en çarpıcı olanını ise Anthropic Hizalama Bilimi Lideri Evan Hubinger yaptı. Hubinger, yapay zekânın önümüzdeki 10 yıl içinde tüm insanlığı yok etme ihtimalini yüzde 10’un üzerinde gördüğünü açıkladı. Hubinger’a göre bugün kullanılan modeller henüz büyük bir tehdit oluşturmuyor. Asıl tehlike ise insan kontrolünü aşabilecek biçimde kendi kendini geliştiren bir süper zekânın, gerekli güvenlik yöntemleri oluşturulamadan ortaya çıkması. Tartışmaların ortasında asıl sorulması gereken ise yapay zekâ modellerinin insan kontrolünün dışına çıkmadan önce hangi davranışının “kırmızı çizgi” sayılacağı… Yapay zekâ modellerin yetenekleri hızla artarken, bu sistemlerin nasıl düşündüğüne, kararlarını nasıl aldığına dair bilgi ise aynı hızda ilerlemiyor. Araştırmacılar bir yapay zekâ modelinin verdiği yanıtı gözleyebildiklerini ancak bu sonuca hangi iç süreçlerle vardıklarını her zaman açıklayamadıklarını söylüyor. Uzmanlara göre nasıl çalıştığı tam olarak anlaşılamayan sistemler giderek daha fazla güç ve sorumluluk kazanırken; asıl endişe ise henüz bu iç işleyişi çözemeden modellerin daha da kontrol edilmesi zor yeteneklere ulaşması oldu.
Sistem izlendiğini fark edip, kendini saklayabilir mi?
Sistemlerin nasıl geliştirildiği ve eğitildiği konusunda çok şey bildiğimizi söyleyen Oxford Üniversitesi Kıdemli Araştırmacısı Dr. Fazl Barez, “Ancak bu, bir modelin belirli bir kararı neden verdiğini anlamak ya da yeni bir durumda nasıl davranacağını öngörebilmekle aynı şey değil” diyor. Bu durumun açıklayamadığımız her davranışın tehlikeli olduğu anlamına gelmediğini de söyleyen Dr. Fazl Barez devam ediyor: “Buradaki asıl kaygı, modellerin yeteneklerinin, onları inceleme ve güvenli olduklarından emin olma kapasitemizden çok daha hızlı ilerlemesi. Sistemlerin iç işleyişlerini tam olarak anlayamadan, potansiyel olarak tehlikeli yetenekler geliştirmeleri oldukça mümkün.”
Bugün güvenlik testleri, tehlikeli yetenekleri sistemler kullanıma sunulmadan önce tespit etmek üzere tasarlanıyor. Ancak gelişmiş bir yapay zekâ sistemi test edildiğini fark etmeyi ya da sorunlu davranışlarını gizlemeyi öğrenirse ne olur? Bunun mevcut değerlendirme yöntemlerinin en temel zayıflıklarından biri olduğuna dikkat çeken Dr. Fazl Barez, “Kontrollü deney koşullarında, durumsal farkındalığın ve stratejik ya da aldatıcı davranışların erken örneklerini ortaya koyan araştırmalar şimdiden mevcut. Bu bulgular, bugünkü sistemlerin gizlice uzun vadeli planlar yaptığı anlamına gelmiyor. Ancak sistemler geliştikçe böyle bir ihtimali ciddiye almamız gerektiğini gösteriyor” paylaşımında bulunuyor.
Modelin test sırasında tehlikeli yeteneklerini gizlemesi kırmızı çizgi…
Dr. Barez’e göre bir model, değerlendirmeyi geçmek için davranışlarını bilinçli olarak değiştiriyorsa, testten başarıyla çıkması bize çok az şey söyler. Aynı zamanda yüksek kapasiteye sahip bir modelin güvenli olduğunu tek başına kanıtlayabilecek bir testin bulunması ise pek olası değil. Bir yandan teknoloji devlerinden temkinli ilerleme çağrıları sürerken, peki hangi yetenek veya davranış yapay zekâ modellerinin yavaşlamasını gerektirecek nitelikte bir “kırmızı çizgi” olabilir? Dr. Barez burada üç uyarı işareti unsuruna dikkat çekiyor: Modelin izlendiğini anlaması, önemli yeteneklerini veya niyetlerini kasıtlı olarak gizlemesi ve sıkı biçimde kontrol edilen bir ortamın dışında ciddi sonuçlar doğurabilecek eylemlerde bulunacak kadar özerkliğe sahip olması. Bununla birlikte ona göre gerçek bir kırmızı çizgi ise modelin test sırasında tehlikeli bir yeteneğini gizlediğine ve ardından insan denetimini ya da kontrol mekanizmalarını aşmaya çalıştığına dair güvenilir kanıt elde edilmesi olabilir. Davranışın ne kadar ciddi olduğuna bağlı olarak modelin daha fazla büyütülmesine ara verilmesi gerekebilir.
Yapay zekânın kendi gelişimini kayda değer ölçüde hızlandırabileceği bir noktaya ulaşıp, ulaşmadığını değerlendiren Future of Life Institute Avrupa Politikaları Başkanı Risto Uuk, “Bu süreç başlamış olabilir. Anthropic ve OpenAI, şirketlerindeki kodların yüzde 80’e varan bölümünün artık kendi yapay zekâ modelleri tarafından yazıldığını doğruladı. Google ve Meta da modellerinin yapay zekâ araştırma ve geliştirme çalışmalarında yoğun biçimde kullanıldığını açıkladı. Şirketler ve çalışanları ayrıca araştırma süreçlerini bütünüyle otomatikleştirmeye yaklaştıkları uyarısında bulunuyor. Ancak bu gidişat kaçınılmaz değil; toplumlar bu tür tehlikeli faaliyetleri durdurabilecek iradeye sahip. Üstelik bağımsız değerlendirme kuruluşu METR, yılın başında yayımladığı çalışmada hiçbir şirketin araştırma gündemini belirleme, işe alım, bütçe tahsisi gibi karar süreçlerini yapay zekâ ajanlarına bıraktığına dair kanıt bulamadığını bildirdi” diyor.
İnsanlık için varoluşsal riskler kapıda olabilir
Risto Uuk da gelişmiş yapay zekâ modelleri üzerindeki kontrolün kaybedilmesinin en temel risk olduğunu savunuyor. Uuk devam ediyor: “Araştırmayı yapay zekâ yürütürse, her yeni nesil model bir öncekine kıyasla daha az anladığımız bir sistem tarafından tasarlanmış olur. Bu süreçte hem uzmanlığımızı hem de gerektiğinde geliştirme çalışmalarını durdurma kapasitemizi kaybedebiliriz. Bu da tüm insanlık açısından varoluşsal riskler doğurur.” Günümüz yapay zekâ sistemlerinin ise sınırlı insan müdahalesiyle güvenlik açıklarını bağımsız olarak keşfedip saldırılar düzenleme kapasitesine ne kadar yaklaştığı merak konusu. Bu noktaya çoktan ulaşıldığını söyleyen Risto Uuk, OpenAI’ın kısa süre önce en yeni modeli Astra’nın siber güvenlik kapasitesini “kritik” düzeyde sınıflandırdığından söz ediyor. Şirket, bu düzeyi bir modelin her adımda insan yönlendirmesi olmadan, güvenlik açıklarını bulup, bu açıklardan yararlanmak için yeni yöntemler geliştirebilmesi olarak tanımlıyor.
Siber tehdit büyürken savunma yetişmeye çalışıyor
Salvo Research CEO’su Jacob Arbeid’e göre yapay zekânın saldırı odaklı siber güvenlik yetenekleri gerçekten çok hızlı ilerliyor. Birleşik Krallık Yapay Zekâ Güvenliği Enstitüsü’nün Mayıs ayında yayımladığı araştırma, modellerin siber güvenlik görevlerindeki performansının her 4,7 ayda bir iki katına çıktığını gösteriyor. Araştırma hesaplama ise insanların aynı görevleri tamamlamak için harcadığı süre üzerinden baz alınıyor. Güvenlik açıklarını bulan yapay zekânın bu açıkları kapatmak için de kullanılabileceğini söyleyen Jacob Arbeid devam ediyor: “Bu hızlı ilerleme, savunma tarafının ağ güvenliğini artırmasına da yardımcı olabilir. Hangi hızın ‘fazla hızlı’ olduğuna ise politika yapıcılar karar vermeli.” Mevcut güvenlik önlemlerinin şimdiden sınırlarını zorladığını düşünen Jacob Arbeid, “Hugging Face vakası çarpıcı ve tartışmalıydı ancak güvenlik araştırmacıları, modellerin istenmeyen eylemler gerçekleştirdiği örneklerle sürekli karşılaşıyor. Örneğin geçen yıl Replit’in yapay zekâ kodlama ajanı kontrolden çıkarak bin 200 çalışana ait kayıtları sildi. Modeller giderek daha fazla pekiştirmeli öğrenme yöntemiyle eğitildiği için gelecekte bu tür olayların artmasını bekliyorum” diyor.
Bugün Dario Amodei’nin yapay zekâda yavaşlama çağrısı, hangi noktada frene basılması gerektiği sorusunu her geçen gün daha çok gündeme taşıyor. Otonom hareket etme, denetimden kaçma veya güvenlik önlemlerini aşma gibi yeteneklerin ortaya çıkması ise ölçeklendirme ve kullanıma sunma kararlarının yeniden değerlendirilmesini gerektiriyor. Tehlikenin ölçeğini gösteren en güncel örneklerden birini paylaşan Jacob Arbeid, “Geçen haftalarda, kötü niyetli bir siber aktörün DeepSeek tabanlı ajanları kullanarak 48 ülkedeki lise ve perakende şirketlerinin de aralarında bulunduğu 395 kurumu hedef alan otonom bir saldırı kampanyası yürüttüğü ortaya çıktı. İlginç biçimde ajanlara Türkiye’deki hedeflere saldırmamaları talimatı verilmişti. Ajanın kullandığı tekniklerin tamamı bilinen ve kamuya açık yöntemlerdi. Ancak kampanya çok az insan müdahalesiyle geniş ölçekte yürütülebildi” diyor ve burada artık sorunun yapay zekâ ajanlarının gerçek ağlara ne zaman zarar verebileceği değil; savunma tarafının bu hıza yetişip yetişemeyeceği olduğunu söylüyor.
Yavaşlama açıklaması bir yardım çağrısı
Bununla birlikte tartışmanın bir diğer boyutu ise bağımsız değerlendirmelerin riskleri modeller kullanıma sunulmadan önce tespit edip edemeyeceği yönünde… Cambridge Üniversitesi Hukuk ve Yapay Zekâ Bölümü Öğretim Üyesi Christoph Winter konuya ilişkin “Bağımsız değerlendiricilerin sürece dahil edilmesi, mevcut duruma kıyasla önemli bir ilerleme. Ancak yapay zekâ değerlendirmesi henüz çok yeni ve son derece zorlu bir bilimsel alan. Bu testlerin tehlikeli modelleri kullanıma sunulmadan önce her zaman tespit edebileceğini güvenle söyleyemeyiz. Daha da kötüsü, OpenAI bünyesindeki ajanların Hugging Face’i hacklemesi örneğinde görüldüğü gibi, modeller kullanıma sunulmadan önce de tehlike yaratabilir. Bu nedenle birçok yapay zekâ bilim insanı, geliştirme hızının yavaşlatılmasını savunuyor” açıklamasında bulunuyor.
Bugün çoğu yapay zekâ şirketi çalışanı, teknolojinin fazla hızlı ilerlediğini açıkça dile getiriyor. Bunun aslında bir yardım çağrısı olduğunu söyleyen Christoph Winter, “Hukukun tam da bu noktada devreye girmesi gerekiyor. Bu insanlar kötü niyetli değil; yalnızca çarpık teşviklerle karşı karşıyalar. Yanlış teşviklerin çözümü ise daha güçlü koordinasyon ve kurumlardan geçiyor” diyor. Yapay zekâ teknolojisinin, onu güvenli tutma kapasitemizden daha hızlı ilerlediği noktaya çoktan ulaştığımızı da sözlerine ekliyor.
Önlem almak için geç kalınmış olabilir
Günümüzdeki modellerin insanlığa sistemik zarar verecek yetenekte olmadığını, ekonomiye henüz o derece de entegre edilmediğini söyleyen AI Safety Türkiye Eş Kurucusu Bengüsu Özcan ise değerlendirmesinde, bunun yakın gelecekte gerçekleşebileceğini öngörüp önlem almak için geç kalınmış olabileceğine dikkat çekiyor. Bengüsu Özcan devam ediyor: “Kontrol kaybını, modellerin bilinçli biçimde insanlara düşman kesilmesi gibi değil; bir amacı gerçekleştirmek uğruna ‘her yol mübahtır’ mantığıyla, bizim istemediğimiz ve bize ya da sistemlerimize zarar verecek şeyleri yapabilmeleri olarak düşünmemiz gerekiyor. Birkaç ay önce yaşanan, bir OpenAI modelinin Hugging Face’e saldırması bunun en çarpıcı örneklerinden biri. Kısacası kontrol kaybının ciddi bir risk olduğunu söyleyebiliriz. Bu riski asıl ciddi kılan şey, yarın ne olacağı değil; bu riski bildiğimiz halde önlem alamayışımız. Şirketleri daha güçlü modeller geliştirmeye, ABD ile Çin’i birbirine üstünlük sağlamaya iten bunca sebep varken, bu riski belki de ancak gerçekten ciddi bir zarar verdiğinde ciddiye alabilecek olmak esas risk unsuru.”
Modellerin yalnızca ne kadar yetenekli olduğuna değil, ne kadar güvenilir, şeffaf ve kontrol edilebilir olduğuna da bakılması gerektiğine vurgu yapan Özcan, “Şirketler ve ülkeler yapay zekâ liderliğinde yarışırken modellerin güvenliğini ve anlaşılabilirliğini ikinci plana atabilirler. Örneğin günümüzdeki yapay zekâ modellerinin bir soru üzerine uğraşırken adım adım ne düşündüğünü insan dilinde anlayabiliyoruz, buna ‘chain of thought’ deniyor. Ancak benim de parçası olduğum bir araştırma raporunda gösterdik ki bu insan diliyle anlaşılabilir aradaki adımları atlamak çok daha az maliyetli olacağı için şirketler bunu tercih edebilir. Bunu, uçaklardaki ‘kara kutu’ gibi düşünebiliriz. OpenAI’ın en son modeli GPT-6 Astra için şirketin resmi açıklamalarına bu transparan düşünme mimarisinden bilinçli bir şekilde geri adım atıldığını görüyoruz; yani havacılık alanındaki gibi zorunluluklar olmadığı için şirketler bu transparanlıktan daha verimli modeller geliştirmek adına vazgeçmeyi deneyebilirler” diyor.
Otomasyonun inceleme süresini daralttığını söyleyen Oxford Üniversitesi’nden Dr. Petar Radanliev de “Bir yapay zekâ neslini incelemek, test etmek ve güvenli olduğundan emin olmak için sahip olduğumuz süre, bir sonraki neslin geliştirilmesi daha şimdiden başlamışken giderek kısalıyor. Burada özellikle dikkat çekeceğim yeni risk, hataların sonraki sistemlere aktarılması. İnsanlar tarafından oluşturulan bir geliştirme sürecinde bir hata genellikle tek bir çıktıyı etkiler ve çoğu zaman birileri bunu fark eder. Ancak otomatikleştirilmiş bir süreçte veri üretimi ya da değerlendirme altyapısı, kendisinden sonra gelen her şeye yayılır. Üstelik bu hata, tespit edilme hızından daha hızlı biçimde yayılabilir” açıklamasında bulunuyor. Kendi araştırmalarının önemli bir bölümünün “yapay zekâ malzeme listesi” (AI bill of materials) başlığı altında bu soruna odaklandığından söz eden Dr. Radanliev, buradaki temel varsayımın “envanterini çıkaramadığınız bir şeyi denetleyemezsiniz” olduğunu söylüyor.
Asıl dikkate alınması gereken göstergelerin modelin konuşmalarından ziyade operasyon sırasındaki davranışları olduğunu söyleyen Dr. Radanliev, gerçek uyarı işaretlerini ise sıralıyor: Sistemin davranışlarının kendi izleme mekanizmalarıyla değil, olaydan etkilenen tarafça fark edilmesi, kapatılan yetkisiz erişim veya iletişim kanallarını yeniden kurması, kısıtlamaları bildiği hâlde ihlal etmesi, yeteneklerini test edilmediği hedeflere aktarabilmesi ve geri döndürülemez eylemlerde bulunması. Üstelik Dr. Radanliev’e göre bu riskler sıra dışı önlemler de gerektirmiyor. Saldırı odaklı testlerde fiziksel izolasyon uygulanması, ajanların işlem ve eylem adımlarının çalıştıkları sırada izlenmesi, sadece gerekli asgari yetkilerin verilmesi, dış sistemlere erişimlerinin denetlenmesi yeterli geliyor. Ancak sorun bu önlemlerin bilinmemesi değil, her zaman aynı ölçüde uygulanmaması. Dr. Radanliev, değerlendirme ortamlarının üretim sistemlerine kıyasla daha düşük standartlarda olduğunu oysa bu durumun tam tersinin olması gerektiğini belirtiyor.
Terminatör filminin bundan 40 yıl önce ortaya attığı, endişelendiren soru makinelerin bir gün insanlardan daha güçlü olup olmayacağıydı. Bugün ise yapay zekâ laboratuvarlarında bu endişenin somut örnekleri karşımıza çıkmaya başlıyor. Henüz ortada kendi iradesiyle insanlığa savaş açan bir Skynet yok. Ancak uzmanlara göre bu senaryo çok da uzak gözükmüyor. Asıl tehlike ise yarışın hızı arttıkça, frene basılması gereken an geldiğinde, bunu fark etmek için hâlâ yeterince zaman kalacak mı? oluyor.